58 Nhóm công ty hoạt động thế nào để bao trùm các loại hình giám sát trên hai chiều ngang và dọc.
Chia thành hai phần chính:
1. Tổng quan về kiến trúc của website
Cấu trúc tổng quan của trang web
Nhóm kinh doanh
Đối với phần lớn các kỹ sư kỹ thuật, *** quen thuộc chính là cluster kinh doanh, chúng ta triển khai logic kinh doanh lên các cluster này, còn lại Nginx phân tán traffic lên các cluster kinh doanh này.
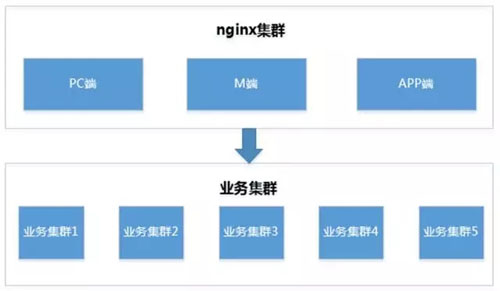
Như hình trên, là cấu trúc liên quan, phần này mọi người đều khá quen thuộc, chúng tôi không cần phải mở rộng. Dưới đây là cấu trúc chi tiết về điểm kết nối lưu lượng bên ngoài và bên trong data center của các trang web lớn.
Phía ngoài nhà máy
Người dùng truy cập vào một trang, từ thanh địa chỉ của trình duyệt nhập vào địa chỉ web, nhấn phím Enter, cho đến khi trang được tải ra, đã trải qua những bước nào?
Lấy một trang web thường thấy làm ví dụ, thông qua các công cụ phát triển trong trình duyệt, chúng ta có thể thấy việc tải và hiển thị trang web này cần tải rất nhiều tài nguyên trang web.
Không chỉ tải về nhiều tài nguyên có định dạng tài liệu, như HTML; mà cũng tải về nhiều tài nguyên tĩnh, như CSS, JS và các tệp hình ảnh.
Chúng tôi sẽ chia trước một loại thành nội dung động, sẽ chia loại sau thành tài nguyên tĩnh. Nếu chúng ta chỉ có một data center trên toàn quốc, thì người dùng trên toàn quốc phải vượt qua nhiều vùng mạng, nhiều nhà mạng để truy cập được vào website, như hình dưới đây, tốc độ truy cập chắc chắn không thể nhanh.
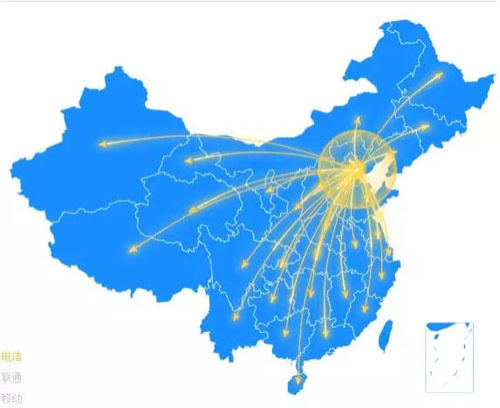
Vấn đề này giải quyết như thế nào? ***Phương pháp đơn giản là cho người dùng truy cập gần nguồn tài nguyên, tạo các nút trong mạng có số lượng người dùng nhiều ở các khu vực, các nhà mạng trên toàn quốc, để người dùng truy cập gần gũi.
Như hình dưới đây, các vòng tròn màu khác nhau đại diện cho các nhà khai thác khác nhau, các nút bao phủ các khu vực có nhiều trang web.
Hầu hết các tài nguyên được tải lên trên trang web đều là các tài nguyên tĩnh, và việc này có thể cải thiện đáng kể tốc độ tải trang.
Công nghệ này chính là công nghệ CDN (Content Delivery Network - Mạng lưới phân phối nội dung).
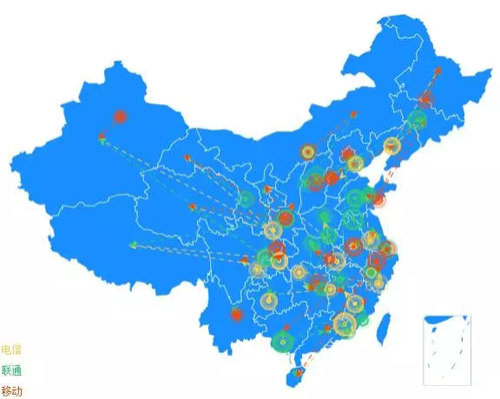
Cách suy nghĩ để tối ưu hóa cho các request động cũng là tương tự, trước đây đã đề cập đến là chỉ có 1 data center cung cấp response cho các request động, speed response cho các user ở phía nam là khá chậm.
Ví dụ như hình, nếu triển khai data center ở khu vực Trung Đông, Nam Trung Quốc, có thể phủ sóng tốt hơn cho người dùng ở Trung Đông, Nam Trung Quốc, nâng cao tốc độ truy cập nội dung động.
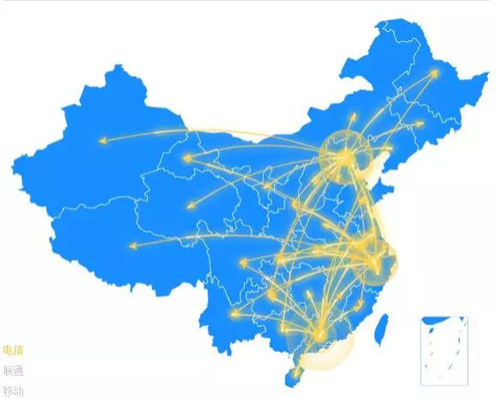
Vậy CDN đó nó làm thế nào để thực hiện việc truy cập gần gũi đến tài nguyên tĩnh của mình呢? Ở đây lại sử dụng đến phương pháp điều độ của DNS.
Chúng ta đều biết các bước thực hiện yêu cầu thông qua giao thức HTTP như sau:
· Phân giải tên miền
· Tạo kết nối
· Gửi yêu cầu
· Nhận phản hồi
Hình như dưới đây, khi người dùng gửi yêu cầu giải mã tên miền đến máy chủ giải mã tên miền, máy chủ DNS trả về IP của nút CDN gần nhất với người dùng, từ đó thực hiện việc truy cập gần gũi.
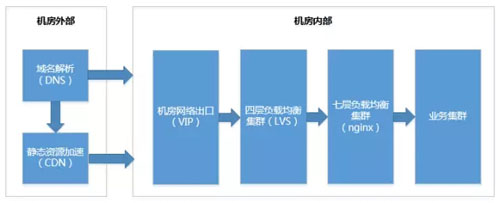
Phía trong của phòng máy
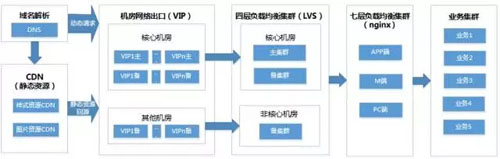
Như hình trên, sau bước phân giải domain name, request động sẽ được truy cập straight vào data center (cũng có thể làm caché content động), resource tĩnh khi không có cache cũng sẽ được back origin (lấy resource file về data center), cả hai trường hợp này đều sẽ truy cập VIP data center.
Lưu lượng sẽ được phân tán ra các cluster load balance 4 layer và 7 layer trước khi được phân phối ra các cluster kinh doanh. Các cluster kinh doanh cũng sẽ có trường hợp gọi API cho nhau.
Mỗi cluser key đều có master-slave, master cluster bị lỗi thì swtich sang slave cluster; cũng có thể master-slave cluster cùng cung cấp dịch vụ, mỗi cluster đều có resource dự phòng để chịu toàn bộ traffic.
Mỗi cluser đều bao gồm nhiều máy chủ, một số máy chủ bị lỗi nhỏ không ảnh hưởng đến cluser cung cấp dịch vụ. Network exit của data center cung cấp đường link dự phòng, đường link chính bị vấn đề có thể tự động chuyển sang đường link dự phòng.
Khi gặp các tình huống khẩn cấp, hai đường link đều bị cut, có thể switch kết quả resolve domain và IP source của CDN sang VIP của room máy chủ dự phòng, sau đó đưa traffic vào qua đường link riêng giữa các room máy chủ. Nếu có nhiều room máy chủ, traffic có thể được switch sang các room máy chủ khác bình thường.
Xây dựng hệ thống giám sát toàn diện
Vị trí và đối tượng của công tác giám sát
Vị trí và đối tượng của công tác giám sát như sau:
· Đ喉 hồn của các dịch vụ trực tuyến, là bảo đảm quan trọng cho sự ổn định của các dịch vụ
· Đảm bảo mắt của người vận hành, R&D, kiểm thử, nhanh chóng phát hiện và khắc phục sự cố
· Lượng hóa và trực quan hóa dữ liệu vận hành để dễ dàng tối ưu hóa website
Mô hình体系结构 của hệ thống giám sát
Módul cơ sở của hệ thống giám sát được xây dựng trên Open-Falcon, các módul trên cùng đã được phát triển sâu hơn, bản đồ kiến trúc hệ thống tổng thể như sau:

Thời lượng ứng dụng giám sát
Kích thước ứng dụng hệ thống giám sát tại Công ty 58 như sau:
· Bao phủ gần 10.000 máy chủ, trong đó có các website trực thuộc 58 Group như 58 Cidades, Gopai, China Talent, Anjuke, Zhuanzhuan.
· Các chỉ số kinh doanh của việc giám sát, hệ thống giám sát đã cấu hình hơn 3000 cluster, gần 3000 template giám sát, gần 3 triệu chỉ số giám sát, xử lý dữ liệu theo thời gian thực mỗi ngày trên 2T.
Tổng quan về hệ thống giám sát đa chiều
Tham khảo bản đồ cấu trúc trang web, hệ thống giám sát toàn diện bao gồm hai chiều dọc và ngang.
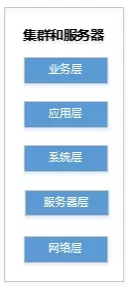
Tích hợp giám sát từ dưới lên các lớp, bao gồm: mạng, máy chủ, hệ điều hành, layer ứng dụng, layer kinh doanh, như hình dưới đây:
Dọc ngang đã thực hiện giám sát từ ngoài vào trong các mức độ, bao gồm các mức độ máy tính, máy chủ, máy chủ truy cập, máy chủ dịch vụ, như hình minh họa dưới đây:
Các chỉ tiêu giám sát theo chiều dọc ở các cấp độ
Theo dõi trên mạng
***Một số công việc cơ bản của việc giám sát mạng bao gồm:
· Cổng ra máy chủ VIP có sống hay không, từ bên ngoài ping VIP, nếu liên tục phát hiện VIP không thông thì báo động.
· Xem xét lưu lượng có bình thường không, giám sát các chỉ tiêu quan trọng như lưu lượng vào ra và số gói dữ liệu trên thiết bị mạng layer 4.
· Xem lưu lượng và chất lượng đường truyền riêng lẻ có bình thường hay không, và các thiết bị mạng và lưu lượng có bình thường hay không, v.v... giám sát lưu lượng và chất lượng đường truyền riêng lẻ trên các thiết bị mạng giữa các trung tâm dữ liệu, như: dung lượng đường truyền, tỷ lệ mất dữ liệu, độ trễ ping, v.v...
Điều khiển máy chủ
Màn hình máy chủ bao gồm máy chủ có bị ngắt kết nối hay không, máy chủ phần cứng có bị lỗi hay không, v.v.
Máy chủ giám sát, tại mỗi phòng máy đều triển khai máy chủ giám sát, thông qua việc ping máy chủ trong cùng một phòng máy để giám sát máy chủ giám sát.
Để tránh ảnh hưởng của network jitter, khi phát hiện ping không thông liên tục nhiều lần thì phát sinh cảnh báo down.
Đặt máy chủ trong cùng một phòng máy chủ để tránh tình trạng báo động lỗi và máy chủ bị ngắt kết nối do vấn đề về đường link mạng giữa các phòng máy chủ.
Trên khía cạnh quản lý giám sát, cấu hình các template khác nhau, gửi các cảnh báo khác nhau cho các cluster, role khác nhau của người dùng, Ví dụ: gửi cảnh báo âm thanh khi máy chủ master cơ sở dữ liệu bị lỗi, các khía cạnh khác hỗ trợ gửi cảnh báo tin nhắn khi máy bị lỗi của máy bị lỗi.
Máy chủ giám sát phần cứng, thông qua việc cài đặt plug-in trên Agent giám sát, có thể hỗ trợ rất tốt cho nhiều loại giám sát phần cứng khác nhau, cũng rất dễ dàng để适配 phần cứng. Tỷ lệ phủ sóng của giám sát phần cứng phụ thuộc vào yêu cầu kinh doanh.
Hệ thống giám sát
Tỷ lệ sử dụng tài nguyên máy chủ, bao gồm các chỉ số CPU, bộ nhớ, đĩa, card mạng, v.v.
Với một công ty Internet vừa và lớn, việc kinh doanh khá phức tạp, các máy chủ được chia thành các cluster khác nhau theo mục đích sử dụng và do các kỹ sư vận hành và phát triển khác nhau quản lý.
Vậy việc thêm các monitoring này sẽ là khối lượng công việc lớn đối với kỹ thuật, và việc chỉ dựa vào con người để thêm monitoring sẽ rất khó đảm bảo được độ phủ của các monitoring. Cảm tưởng của chúng tôi là tự động hóa việc thêm các monitoring cơ bản một cách nhiều nhất có thể.
Chúng tôi đã tổng hợp nhu cầu của các dịch vụ ở khía cạnh giám sát hệ thống, xác định một số chỉ số giám sát, điều kiện đánh giá ngoại lệ, phương thức cảnh báo, v.v., và tạo ra một mẫu giám sát mặc định.
Hệ thống CMDB của chúng ta chứa đựng dữ liệu cơ bản về tài sản máy chủ, bao gồm tên của cluster, danh sách máy chủ trong cluster, người phụ trách OPE và Nghiên cứu phát triển của cluster, v.v.
Vì vậy có thể đồng bộ hóa các thông tin này từ CMDB, tự động thêm các hệ thống giám sát cơ bản cho mỗi cluster trong hệ thống giám sát, tức là tự động thêm cluster, tự động tạo template giám sát (inhu diệp template giám sát cơ bản), cảnh báo tự động gửi cho người phụ trách vận hành và phát triển theo yêu cầu.
Nhờ vậy, trong thời gian ngắn đã đạt được 100% phủ sóng giám sát cơ bản cho tất cả các cluster, ít nhất là các vấn đề gây ra sự cố máy chủ và tỷ lệ sử dụng tài nguyên hệ thống có thể phát hiện hiệu quả, giải quyết nhanh chóng các điểm cốt lõi của giai đoạn ban đầu xây dựng hệ thống giám sát.
Đối với một số cluster, do tính chất đặc thù của kinh doanh, template giám sát cơ bản không đáp ứng được nhu cầu của nó, có thể kế thừa các chỉ số giám sát của template cha, sau đó điều chỉnh các điều kiện cảnh báo, phương thức cảnh báo.
Điều khiển ứng dụng
Điều khiển ứng dụng được sử dụng để giám sát các ứng dụng được triển khai có bình thường hay không, bao gồm các chỉ số như: cổng, tiến trình, chức năng (trang hoặc giao diện), QPS, số kết nối, v.v.
Nhìn chung, để các nhân viên vận hành và phát triển tự động hóa việc tạo các template giám sát, liên kết với cluster, cấu hình người nhận cảnh báo... có khối lượng công việc nhất định và cũng có độ khó nhất định. Một số trường hợp, do vấn đề cấu hình mà dẫn đến việc giám sát và cảnh báo không thể phát huy hiệu quả.
Để giải quyết vấn đề này, chúng tôi dựa trên hệ thống giám sát tự động thêm:
· Một phần từ triển khai hệ thống online đồng bộ thông tin cổng ứng dụng v.v., tự động thêm cổng giám sát.
· Một phương thức khác dựa trên việc sử dụng các template giám sát hệ thống, cho phép người dùng dễ dàng thêm các ứng dụng giám sát, chẳng hạn như: chỉ cần điền các thông tin như port, tên tiến trình là có thể dễ dàng thêm các port giám sát và tiến trình giám sát.
Với các chỉ số như tính năng (trang hoặc giao diện), QPS, số kết nối, v.v., chúng tôi cũng cung cấp cách thức triển khai các plug-in giám sát để giám sát.
Người dùng có thể tải xuống các mẫu plug-in theo dõi của nhiều ngôn ngữ (Java, PHP, Python, Shell, v.v.) thông qua các trang tài liệu hướng dẫn, sau đó thực hiện các sửa đổi đơn giản, sau khi thu thập các chỉ số được theo dõi có thể dễ dàng kết nối với hệ thống theo dõi.
Nhờ đó chúng tôi đã nhanh chóng nâng cao tỷ lệ phủ sóng của việc giám sát ứng dụng.
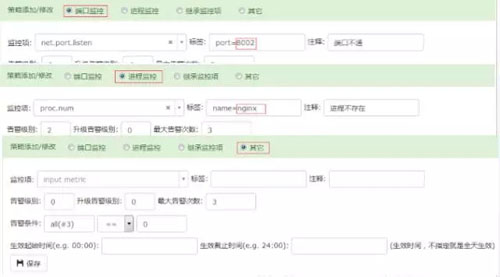
Theo dõi kinh doanh
Objective của việc giám sát bao gồm các chỉ số mà doanh nghiệp quan tâm, chẳng hạn như số lượng đơn hàng, doanh số giao dịch, v.v.
Vì việc giám sát kinh doanh và liên quan đến các công việc kinh doanh cụ thể, không thể áp dụng cách giám sát chung, do đó áp dụng cách giám sát插件自定义。
Các chỉ số có thể collect được đều có thể thêm vào việc monitor và alarm; gửi dữ liệu dưới dạng Json cho Agent monitor là hoàn thành việc báo cáo dữ liệu.
Các chỉ tiêu giám sát theo từng cấp dọc
Client-end
Có một số cách thu thập dữ liệu như:
· Dùng các thiết bị cảm biến được cài đặt trên máy tính hoặc điện thoại của người dùng trong mạng nội bộ của các đối tác để phát hiện.
· Thêm mã JS vào trang để collect dữ liệu hiệu suất từ trình duyệt của người dùng thật.
· Cài đặt SDK vào APP end, collect data về việc truy cập lỗi và dữ liệu hiệu suất từ APP của người dùng thật.
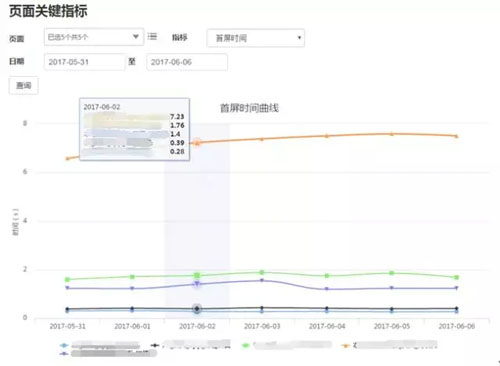
Dữ liệu thu thập bao gồm khả năng sử dụng tại client, thời gian tải trang đầu tiên, thời gian tải toàn bộ tài nguyên, số lượng bit tải toàn bộ tài nguyên, thời gian tải toàn bộ HTML cơ bản, v.v., như hình minh họa dưới đây:
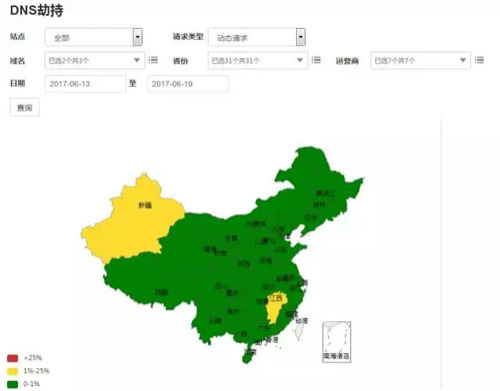
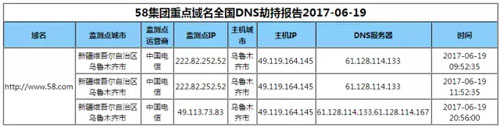
Ngoài ra, có thể cảnh báo các vấn đề như: tấn công chèn ép DNS, tấn công chèn ép link, lỗi truy cập, tốc độ truy cập chậm, với ví dụ về việc hiển thị dữ liệu tấn công chèn ép DNS
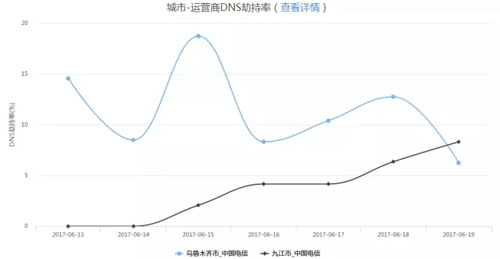
Nhấn vào biểu tượng, chuyển sang dữ liệu chi tiết:
Phía出口 của mạng máy chủ
Theo dõi trang và giao diện
Điều tra các trang web, giao diện quan trọng, khả năng sử dụng, thời gian phản hồi.
Các monitor này đều là request từ VIP của出口 ra data center, traffic được balance service phân phát ra các cluster dịch vụ phía sau, trong cluster dịch vụ có một số server bị lỗi, balance service sẽ tự động thử lại lên máy khác, lỗi sẽ không bị lộ ra cho người dùng bên ngoài.
Khi các trang và giao diện được phát hiện có vấn đề ở đây, điều này có nghĩa là người dùng đã thấy, đó là một sự cố nghiêm trọng.
Phương thức giám sát này cũng có thể đánh giá một cách khách quan tình trạng hoạt động của các clúster dịch vụ, tập trung vào sự ổn định của các chỉ số và thời gian phản hồi.
Theo dõi trang: Đánh giá trang cơ bản (HTML) của trang, liên tục phát hiện trạng thái mã không nhất quán với dự kiến, thời gian phản hồi quá dài, không tìm thấy từ khóa phù hợp, độ dài trang ngắn hơn so với trước đó sẽ cảnh báo.
Monitoing giao diện: Kiểm tra giao diện, phát hiện trạng thái mã không nhất quán với dự kiến, thời gian phản hồi quá dài, mã trạng thái kinh doanh trong đối tượng trả về của giao diện không phù hợp với dự kiến hoặc độ dài dữ liệu ngắn hơn so với dự kiến, cảnh báo trong thời gian liên tục.
Lượng truy cập đầu cuối
Lượng truy cập vào các website lớn bao gồm các cluster cân bằng tải 4 layer và 7 layer.
Các website thông thường có thể sử dụng LVS để cung cấp dịch vụ cân bằng tải 4 layer, các công ty có tiềm lực mạnh có thể sử dụng dịch vụ cân bằng tải 4 layer do mình phát triển.
Lớp 7 load balance là dịch vụ quan trọng của điểm vào của lưu lượng, là cổng vào của lưu lượng người dùng, quan trọng không thể phủ nhận, vì vậy cần có hệ thống giám sát đầy đủ.
Ngoài ra, do tất cả lưu lượng đều đi qua dịch vụ này, nên có thể thu thập được nhiều dữ liệu về tình trạng truy cập của người dùng và hoạt động của các cluser kinh doanh phía sau.
Dịch vụ cân bằng tải thông thường có 7 lớp sử dụng Nginx, ngoài việc giám sát các lớp máy chủ, hệ thống, ứng dụng cơ bản, có thể thực hiện nhiều hơn nữa.
Có một số cách để thực hiện:
· Gửi log real-time, tính toán tập trung, và trả kết quả cho server dịch vụ giám sát.
· Tính toán log trực tiếp trên Nginx, gửi kết quả lên server-end của dịch vụ giám sát.
· Implement Nginx modules bằng Lua, tính toán thời gian, gửi kết quả đến server end của dịch vụ giám sát.
Chúng tôi đã áp dụng *** cách, tính toán phức tạp không chiếm tài nguyên tính toán của集群 Nginx.
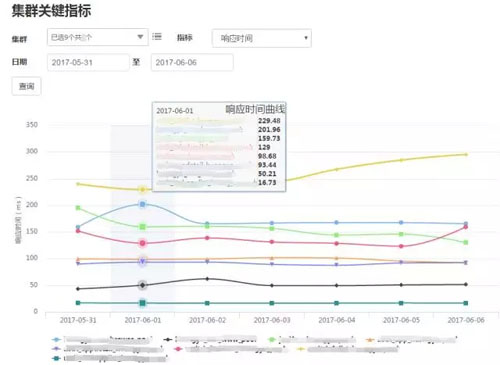
Các chỉ số thu thập bao gồm (như hình dưới):
· Số lượng và tỷ lệ các mã trạng thái khác nhau của các domain name, thời gian phản hồi.
· Số lượng và tỷ lệ các mã trạng thái khác nhau của các cluster hậu cần, thời gian phản hồi.
Kết thúc kinh doanh
Tại các điểm kết nối lưu lượng đã có khả năng giám sát và cảnh báo các chỉ số quan trọng như khả năng sử dụng, thời gian phản hồi của các cluster dịch vụ, có thể thêm các chỉ số giám sát theo từng mức độ của các cluster dịch vụ theo hướng đứng.
Các chức năng khác của core
Hiển thị dữ liệu giám sát
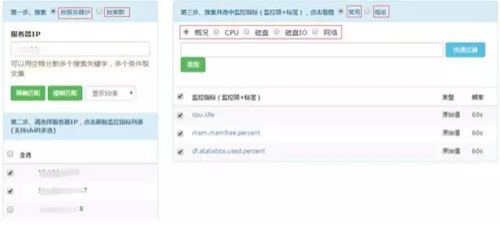
Người dùng có thể xem các chỉ số giám sát theo server và cluster, để thuận tiện cho người dùng có thể directly query các chỉ số giám sát *** thường dùng.
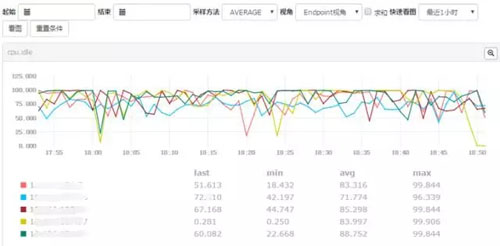
Bạn có thể hiển thị một chỉ số theo dõi của tất cả các máy trong một màn hình:
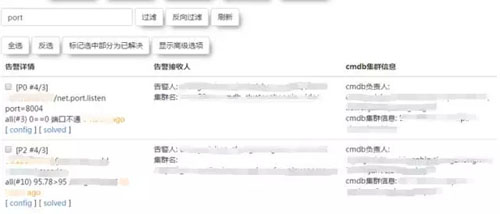
Điều tra lỗi monitor
Để người dùng có thể dễ dàng xem các lỗi hiện tại, chúng tôi đã cung cấp trang xem lỗi đang được giám sát và có thể tìm kiếm thông tin:
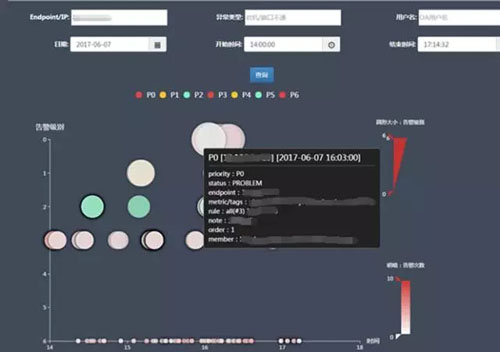
Ngoài ra bạn có thể xem tất cả các cảnh báo gần đây trên trục thời gian:
Tường kiểm soát
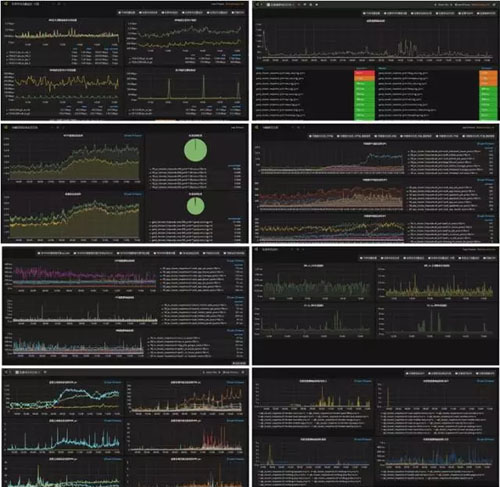
Để thuận tiện cho việc trực và kiểm tra, chúng tôi đã cung cấp chức năng màn hình giám sát tường có thể hiển thị trên màn hình giám sát lớn:
Quản lý dung lượng
Để nâng cao hiệu quả sử dụng tài nguyên máy chủ, phát hiện kịp thời các điểm nghẽn về hiệu suất hệ thống, cung cấp dữ liệu hỗ trợ cho việc xin thêm máy chủ, trên cơ sở dữ liệu của hệ thống giám sát, chúng tôi đã phát triển hệ thống quản lý dung lượng.
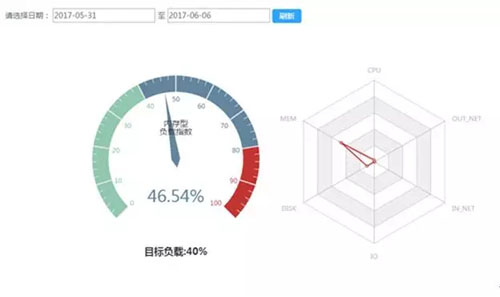
***Bước tiên là thực hiện đánh giá dung lượng cơ bản của cluster, phân tích tải trọng cluster thông qua một số tham số tải trọng hệ thống chính (CPU, bộ nhớ, không gian đĩa, IO đĩa, tỷ lệ sử dụng lưu lượng vào ra của card mạng). Tiếp theo có thể thêm vào nhiều chỉ số kinh doanh hơn để quản lý dung lượng.